同一天,两家公司都在告诉开发者一件事:
更强已经不够了,下一轮模型战争要开始比“完成同一个任务到底花多少钱”。
9 月 22 日,Anthropic 推出 Claude Opus 5.5。官方称,它在多数工作上的能力接近 Claude Fable 5.1,同时典型工作负载相较 Opus 5 可降低约 40% 的运行成本。
几乎同一时间,OpenAI 推出 GPT-6 Sol 和 GPT-6 Luna,把 GPT-6 系列能力向更低成本档位下放。
表面上,这是又一次模型发布撞车。但如果你正在使用 Claude Code、Codex、Coding Agent,或者每天都在大量烧 API,这次真正应该看的已经不是 Benchmark 第一名是谁。
以前大家比谁最聪明,现在开始比谁能用更低成本真正把任务做完。
Opus 5.5:降的不只是 Token 单价
Claude Opus 5.5 的 API 定价是:
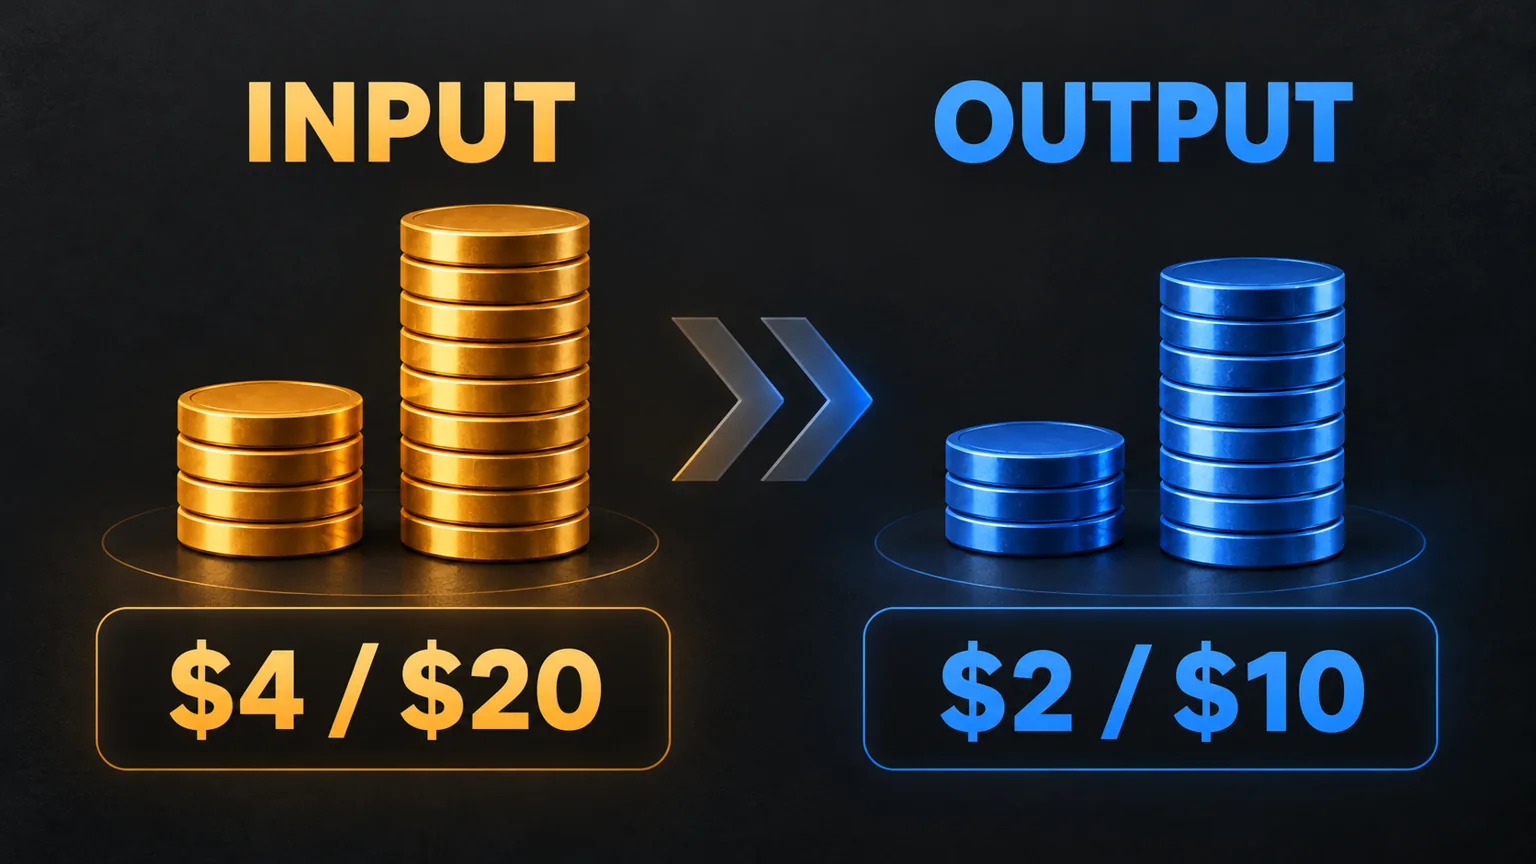
- 输入:$4 / 1M tokens
- 输出:$20 / 1M tokens
相比 Opus 5,标价下降约 20%。但 Anthropic 强调的是:在典型工作负载下,实际运行成本可以降低约 40%。
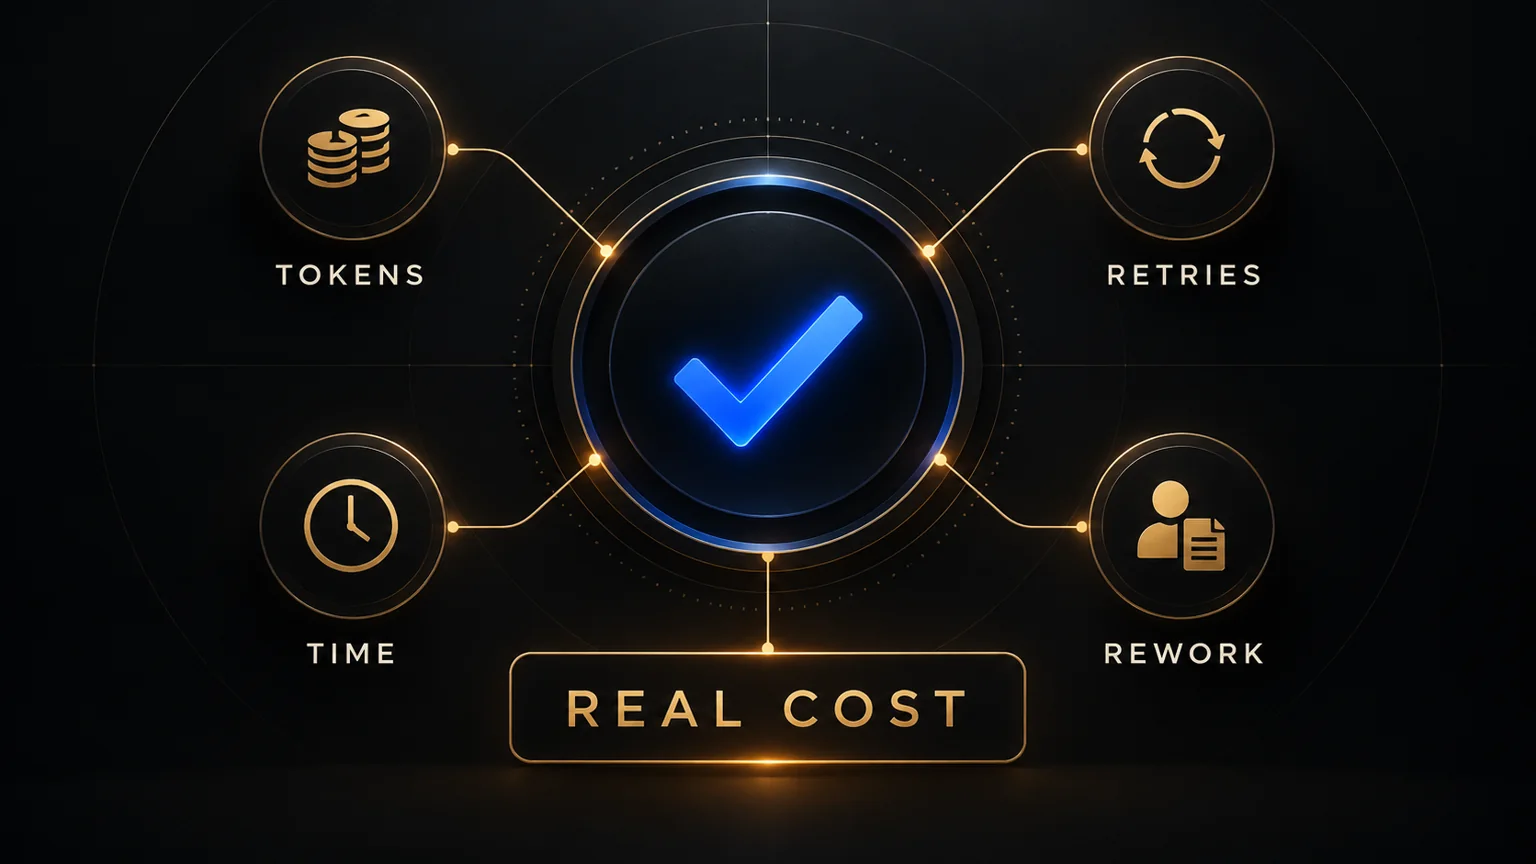
因为 Agent 真正的成本不是简单的 Token 单价,而是:
模型价格 × Token 消耗 × 工具调用 × 重试次数 + 人工返工
如果模型少绕一次路、少改坏一次代码、少跑两轮测试,最终任务成本可能下降得更多。
OpenAI:把 Sol 压到 $2 / $10
GPT-6 Sol 的 API 定价为:
- 输入:$2 / 1M tokens
- 输出:$10 / 1M tokens
GPT-6 Luna 更低:
- 输入:$0.10 / 1M tokens
- 输出:$0.50 / 1M tokens
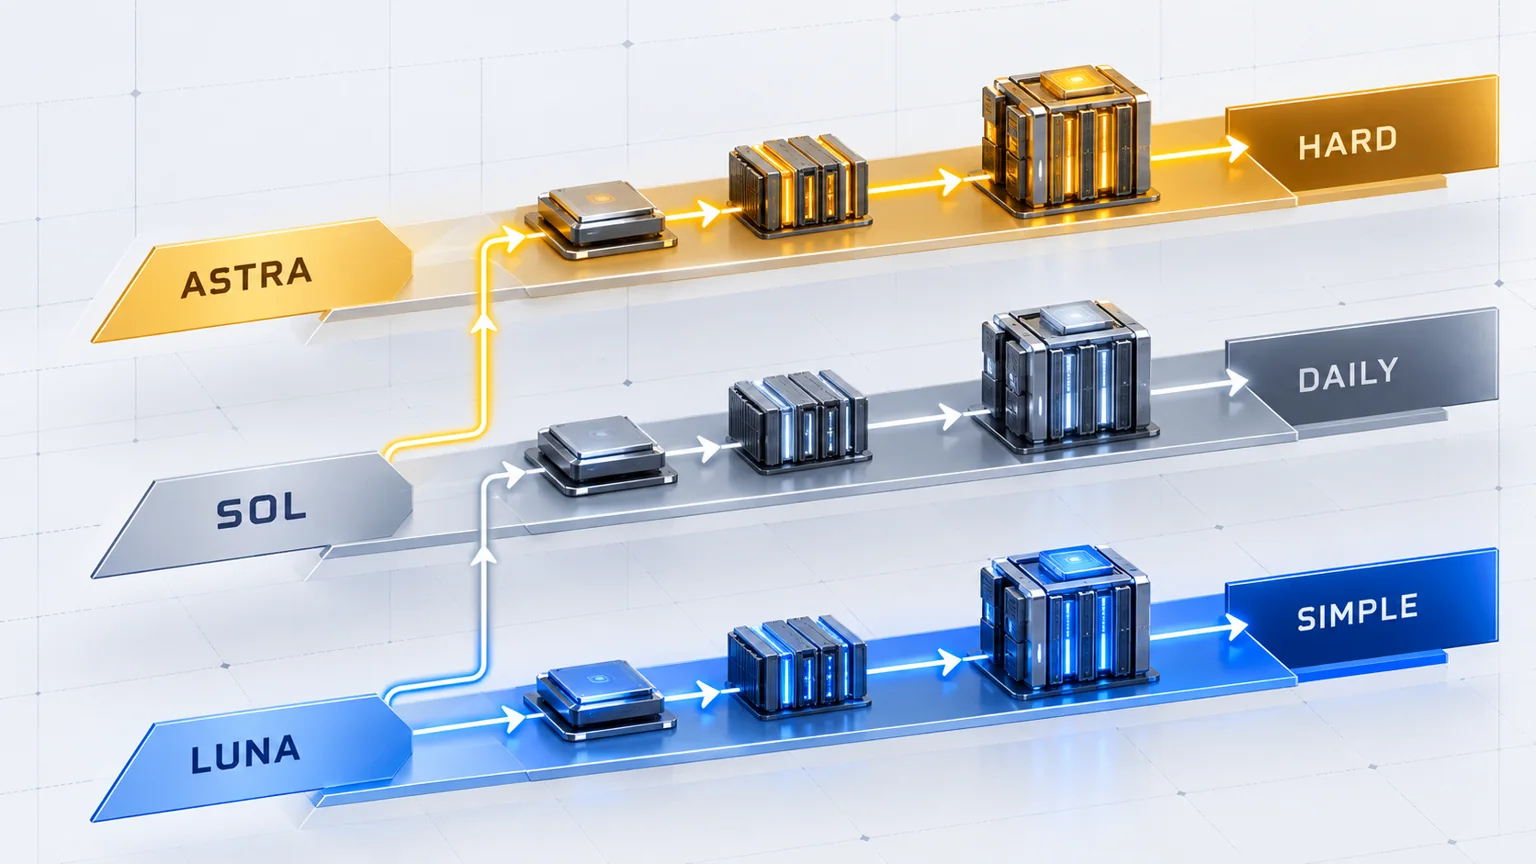
这时候 GPT-6 产品线的打法已经很清楚:
简单任务 → Luna
普通复杂任务 / 日常 Agent → Sol
真正困难任务 → Astra
为什么不能只看 Benchmark?
真正让 Coding Agent 连续跑一天,更重要的是:
- 第一次有没有理解对需求;
- 会不会把正常代码改坏;
- 工具调用是否稳定;
- 报错以后能不能自己恢复;
- 长任务会不会忘记约束;
- 最终需要多少人工修改;
- 完成一次任务总共烧掉多少 Token。
以后更应该关注:
Cost per completed task——每成功完成一个任务的真实成本。
一个模型便宜 50%,但同一个任务需要跑三遍,它未必便宜。
现在该不该换模型?
不要看到新模型就全量切换。
从自己的真实任务中抽 30–100 个:
Claude Opus 5.5 vs GPT-6 Sol vs 当前生产模型
记录:
- 一次成功率
- 总 Token
- 完成时间
- 重试次数
- 人工介入时间
最后计算:
真实任务成本 = API 成本 + 失败重试 + 人工返工
这个结果比网上任何排行榜更适合决定默认模型。
结论
这轮发布最值得记住的,不是谁暂时坐上第一,而是 Anthropic 和 OpenAI 都开始把“更便宜”摆到核心位置。
过去前沿 AI 的故事是“我比上一代聪明多少”。
现在正在变成:
我能不能用更少的钱把同一件事做完。
Agent 时代真正的模型价格战,才刚开始。
